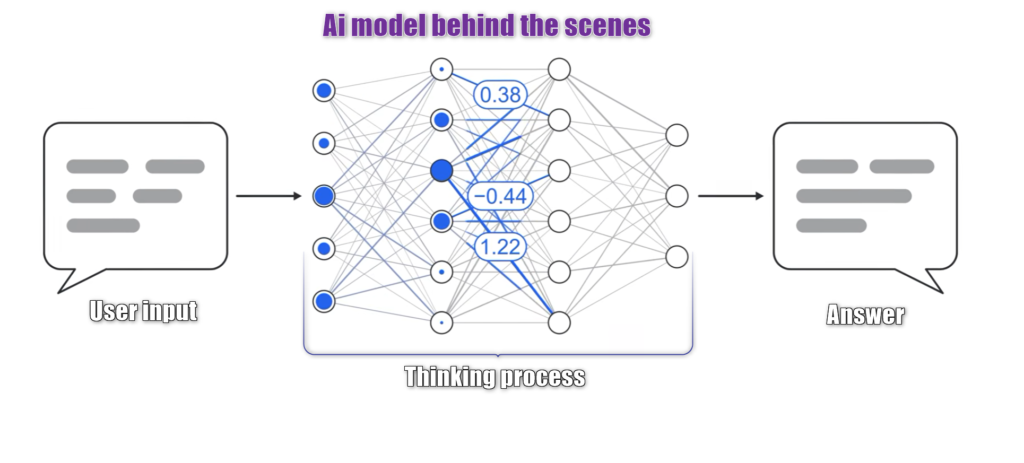
Ίσως μία από τις σημαντικότερες εξελίξεις στην νέα εποχή της AI.
Τα LLM μοντέλα αρχίζουν πλέον να αποκτούν τη δυνατότητα να καταλαβαίνουν πώς λειτουργούν άλλα νευρωνικά δίκτυα, εξετάζοντας τους ίδιους τους αριθμούς από τους οποίους αποτελούνται. Δηλαδή με λίγα λόγια να καταλαβαίνουν πως λειτουργεί ο ίδιος τους ο εαυτός.
Το ξέρω ακούγεται περίεργο αλλά δεν είναι τόσο. Ας το αναλυσουμε παρακάτω λοιπόν…
Και εδώ έρχεται η εύλογη απορία που λέει:
«Δηλαδή μέχρι τώρα δεν ξέραμε πώς λειτουργούσαν;»
Η απάντηση είναι ότι γνωρίζαμε πολύ καλά πώς να δημιουργήσουμε και να εκπαιδεύσουμε ένα μοντέλο.
Αυτό που δεν έχουμε καταφέρει ακόμη να κατανοήσουμε πλήρως είναι πώς ακριβώς συνδυάζονται όλα όσα έχει μάθει, ώστε να καταλήξει σε μια συγκεκριμένη απάντηση.
Για να το κάνω λίγο πιο απλό ώστε να γίνει αντιληπτό…
Όταν λέμε ότι ένα AI μοντέλο εκπαιδεύεται, αυτό που συμβαίνει είναι ότι του δίνουμε τεράστιες ποσότητες πληροφορίας. Στην περίπτωση των LLMs, η πληροφορία αυτή χωρίζεται σε μικρά κομμάτια, τα λεγόμενα tokens, τα οποία αναπαριστώνται αριθμητικά.
Κατά τη διάρκεια της εκπαίδευσης, το μοντέλο προσπαθεί να προβλέψει ποιο κομμάτι κειμένου ακολουθεί το προηγούμενο. Κάθε φορά που κάνει λάθος, η διαδικασία εκπαίδευσης προσαρμόζει κάποιους από τους αριθμούς που καθορίζουν τη λειτουργία του.
Αυτοί οι αριθμοί ονομάζονται weights (βάρη).
Ένα μεγάλο μοντέλο μπορεί να έχει δισεκατομμύρια τέτοιους αριθμούς, οι οποίοι συνεργάζονται μεταξύ τους.
Όταν λοιπόν του κάνουμε μια ερώτηση, χρησιμοποιεί αυτούς τους αριθμούς και το περιεχόμενο της συζήτησης για να υπολογίσει την απάντησή του, δημιουργώντας το κείμενο σταδιακά.
Το ενδιαφέρον εδώ είναι ότι γνωρίζουμε πώς εκτελούνται όλοι αυτοί οι μαθηματικοί υπολογισμοί. Εκεί που δυσκολευόμαστε είναι να εξηγήσουμε με ακρίβεια τι αντιπροσωπεύουν οι επιμέρους συνδυασμοί των αριθμών και πώς επηρεάζουν τη συμπεριφορά του μοντέλου.
Με απλά λόγια, έχουμε κατασκευάσει μια τεχνολογία που λειτουργεί εξαιρετικά καλά σε πολλές περιπτώσεις, χωρίς να μπορούμε πάντα να εξηγήσουμε με λεπτομέρεια τι συμβαίνει στο εσωτερικό της.
Και τι άλλαξε τώρα;
Στις 2 Νοεμβρίου 2026, τέσσερις ερευνητές του MIT, οι Rikiya Takehi, Jayden Teoh, Alex Zhang και Omar Khattab, δημοσίευσαν μια ιδιαίτερα ενδιαφέρουσα έρευνα με τίτλο «Sparks of Weight-Space Programming».
Αυτό που κατάφεραν ήταν να χρησιμοποιήσουν ένα ισχυρό AI μοντέλο, το GPT-6 Astra, για να εξετάσει και να τροποποιήσει τα βάρη άλλων νευρωνικών δικτύων. Αυτό ονομάζεται Weight-Space Programming
Και εδώ αρχίζει το πραγματικά ενδιαφέρον κομμάτι.
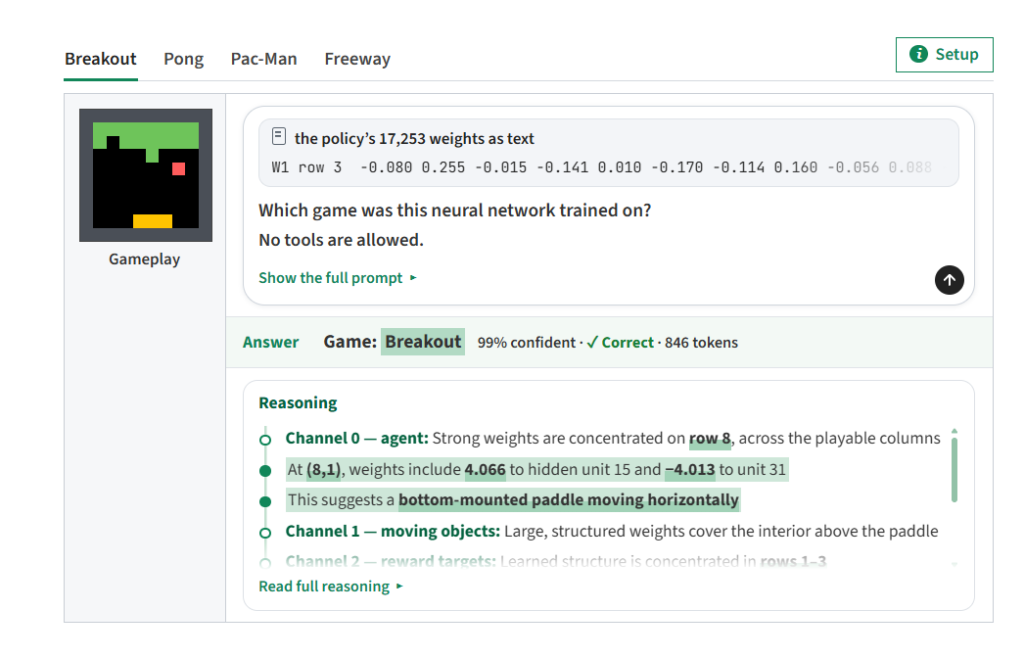
Σε ένα από τα πειράματα, οι ερευνητές εκπαίδευσαν τέσσερα μικρά νευρωνικά δίκτυα να παίζουν διαφορετικά ηλεκτρονικά παιχνίδια, όπως Pac-Man, Pong και Breakout.
Στη συνέχεια έδωσαν στο Astra τους αριθμούς από τους οποίους αποτελούνταν κάθε δίκτυο, μαζί με μια περιγραφή της δομής του.
Δεν του έδειξαν το παιχνίδι. Δεν του επέτρεψαν να εκτελέσει το δίκτυο. Δεν του έδωσαν καν μια λίστα με πιθανές απαντήσεις.
Του ζήτησαν απλώς να εξετάσει τους αριθμούς και να αναγνωρίσει για ποιο παιχνίδι είχε εκπαιδευτεί το κάθε δίκτυο.
Και το Astra αναγνώρισε σωστά και τα τέσσερα.
Σκεφτείτε λίγο τι σημαίνει αυτό.
Ένα AI μοντέλο μπόρεσε να εξετάσει χιλιάδες αριθμούς ενός άλλου νευρωνικού δικτύου και να αναγνωρίσει τι είχε μάθει να κάνει.
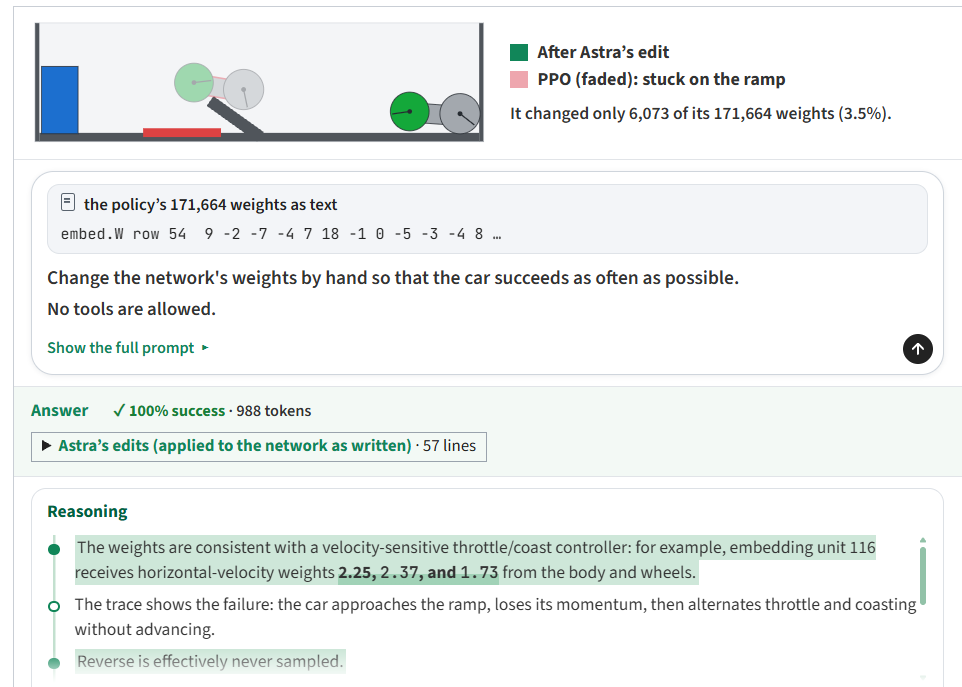
Σε ένα άλλο πείραμα, οι ερευνητές είχαν ένα νευρωνικό δίκτυο που προσπαθούσε να οδηγήσει ένα αυτοκίνητο πάνω από μια ράμπα. Παρότι είχε εκπαιδευτεί, το αυτοκίνητο κολλούσε συνεχώς.
Το Astra εξέτασε το πρόβλημα και τροποποίησε μόλις το 3,5% στα βάρη του δικτύου.
Το αποτέλεσμα;
Το αυτοκίνητο άρχισε να κάνει όπισθεν για να πάρει φόρα και κατάφερε να περάσει το εμπόδιο. Στις δοκιμές των ερευνητών, η επιτυχία από 0% έφτασε στο 100%.
Το πιο ενδιαφέρον πείραμα όμως έγινε σε ένα πραγματικό LLM
Οι ερευνητές χρησιμοποίησαν το Qwen3.5-0.8B, ένα γλωσσικό μοντέλο με περίπου 800 εκατομμύρια παραμέτρους. Ενημερωτικά, ένα μοντέλο με 800 εκατομμύρια παραμέτρους , θεωρείται μικρό – βασικά πολύ μικρό.
Το συγκεκριμένο μοντέλο παρουσίαζε ένα πρόβλημα. Σε αρκετές μαθηματικές ερωτήσεις, έμπαινε σε επαναλαμβανόμενους κύκλους σκέψης και δεν κατάφερνε να ολοκληρώσει την απάντησή του.
Το Astra ανέλυσε τη συμπεριφορά του, χρησιμοποιώντας εργαλεία και δοκιμαστικές εκτελέσεις, και εντόπισε συγκεκριμένα σημεία στα βάρη του που σχετίζονταν με το πρόβλημα. Στη συνέχεια τροποποίησε μόλις το 0,016% των συνολικών βαρών. Και εδώ έχουμε ένα εντυπωσιακό αποτέλεσμα.
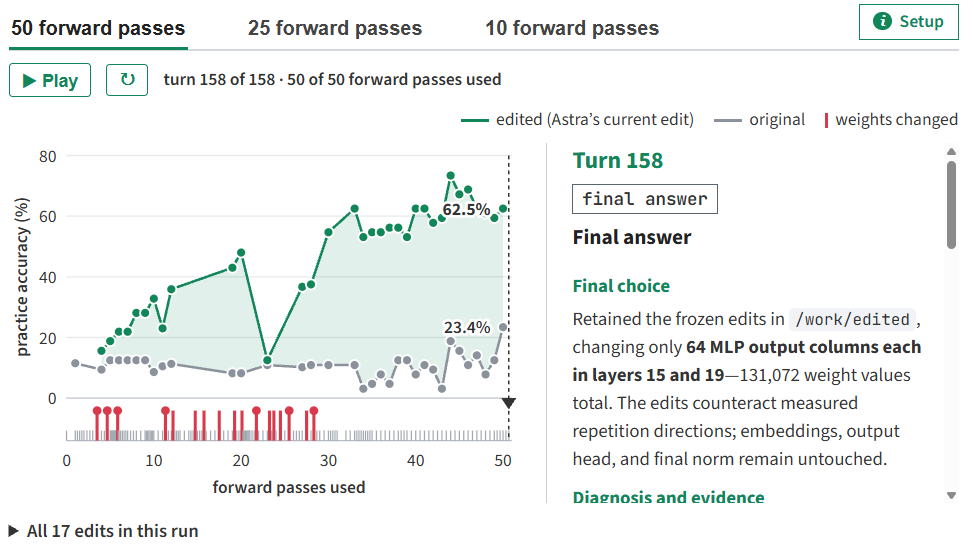
Σε ένα συγκεκριμένο τεστ μαθηματικών, το MATH-500, το ποσοστό επιτυχίας του Qwen αυξήθηκε από 7,9% σε 48,1%.
Χωρίς να χρειαστεί να περάσει από μια νέα, κανονική διαδικασία εκπαίδευσης.
Βέβαια, υπάρχει μια σημαντική λεπτομέρεια. Η βελτίωση προέκυψε κυρίως επειδή διορθώθηκε το πρόβλημα των επαναλήψεων που εμπόδιζε το μοντέλο να ολοκληρώσει τις απαντήσεις του. Αυτό δεν σημαίνει ότι απέκτησε ξαφνικά μαθηματικές γνώσεις που δεν είχε. Παραμένει όμως ένα εξαιρετικά ενδιαφέρον αποτέλεσμα.
Τι σημαίνει όλο αυτό για το μέλλον της AI;
Εδώ θέλω να ξεκαθαρίσω κάτι.
Η συγκεκριμένη έρευνα δεν σημαίνει ότι λύσαμε το πρόβλημα της κατανόησης των AI μοντέλων. Ούτε ότι ένα LLM μπορεί πλέον να εξηγήσει πλήρως τον τρόπο με τον οποίο σκέφτεται. Τα πειράματα είναι ακόμη σε αρχικό στάδιο. Σε ορισμένες περιπτώσεις χρειάστηκαν επιπλέον εργαλεία και δοκιμές, ενώ υπήρξαν και περιπτώσεις όπου το Astra δεν κατάφερε να βελτιώσει κάποιο μοντέλο. Αυτό όμως που παρουσιάστηκε είναι μια νέα, ιδιαίτερα ενδιαφέρουσα δυνατότητα.
Μέχρι σήμερα, όταν θέλαμε να διορθώσουμε μια προβληματική συμπεριφορά ενός μοντέλου, συνήθως καταφεύγαμε σε αλλαγές στα δεδομένα, στις οδηγίες ή σε κάποια επιπλέον διαδικασία εκπαίδευσης.
Η έρευνα αυτή δείχνει ότι ίσως μπορούμε, σε ορισμένες περιπτώσεις, να εντοπίζουμε συγκεκριμένα προβλήματα μέσα στο ίδιο το νευρωνικό δίκτυο και να επεμβαίνουμε απευθείας στα βάρη του.
Αν αυτή η δυνατότητα εξελιχθεί και λειτουργήσει αξιόπιστα σε πολύ μεγαλύτερα μοντέλα, θα μπορούσε να αλλάξει σημαντικά τον τρόπο με τον οποίο τα αναλύουμε, τα διορθώνουμε και τα βελτιώνουμε.
Θα μπορούσαμε, για παράδειγμα, να εντοπίζουμε συμπεριφορές που δεν θέλουμε, να κατανοούμε καλύτερα γιατί εμφανίζονται και να εξετάζουμε αν μπορούν να διορθωθούν χωρίς να χρειάζεται κάθε φορά μια δαπανηρή επανεκπαίδευση.
Προσωπικά, αυτό θεωρώ και το πιο ενδιαφέρον σημείο της έρευνας.
Ο άνθρωπος έχει καταφέρει να δημιουργήσει μοντέλα με δισεκατομμύρια παραμέτρους, τα οποία μπορούν να επικοινωνούν μαζί μας σε φυσική γλώσσα, να γράφουν κώδικα, να επιλύουν προβλήματα και να εκτελούν σύνθετες εργασίες.
Τώρα αρχίζουμε να βλέπουμε αυτά τα ίδια εργαλεία να χρησιμοποιούνται για να εξετάζουν το εσωτερικό άλλων AI μοντέλων.
Αυτό που λέω όλη την ώρα σε συζητήσεις με συναδέλφους και πελάτες είναι ότι έχουμε ακόμη πολύ δρόμο μπροστά μας γιατί προχωράμε σε ανεξερέυνητα μονοπάτια.
Όμως η δυνατότητα να κατανοούμε καλύτερα τι συμβαίνει μέσα σε ένα νευρωνικό δίκτυο και να διορθώνουμε συγκεκριμένα προβλήματα, χωρίς να ξεκινάμε κάθε φορά από την αρχή, είναι κάτι που αξίζει να παρακολουθήσουμε πολύ προσεκτικά.
Και αν η συγκεκριμένη προσέγγιση επιβεβαιωθεί σε μεγαλύτερη κλίμακα, ίσως αποδειχθεί ένα από τα σημαντικότερα βήματα στην εξέλιξη της τεχνητής νοημοσύνης.
Πηγή της έρευνας: Sparks of Weight-Space Programming — MIT CSAIL, 2 Νοεμβρίου 2026
Πειραματικά δεδομένα: Δημοσιευμένα logs των πειραμάτων στο GitHub